Automatización de procesos: por dónde empezar
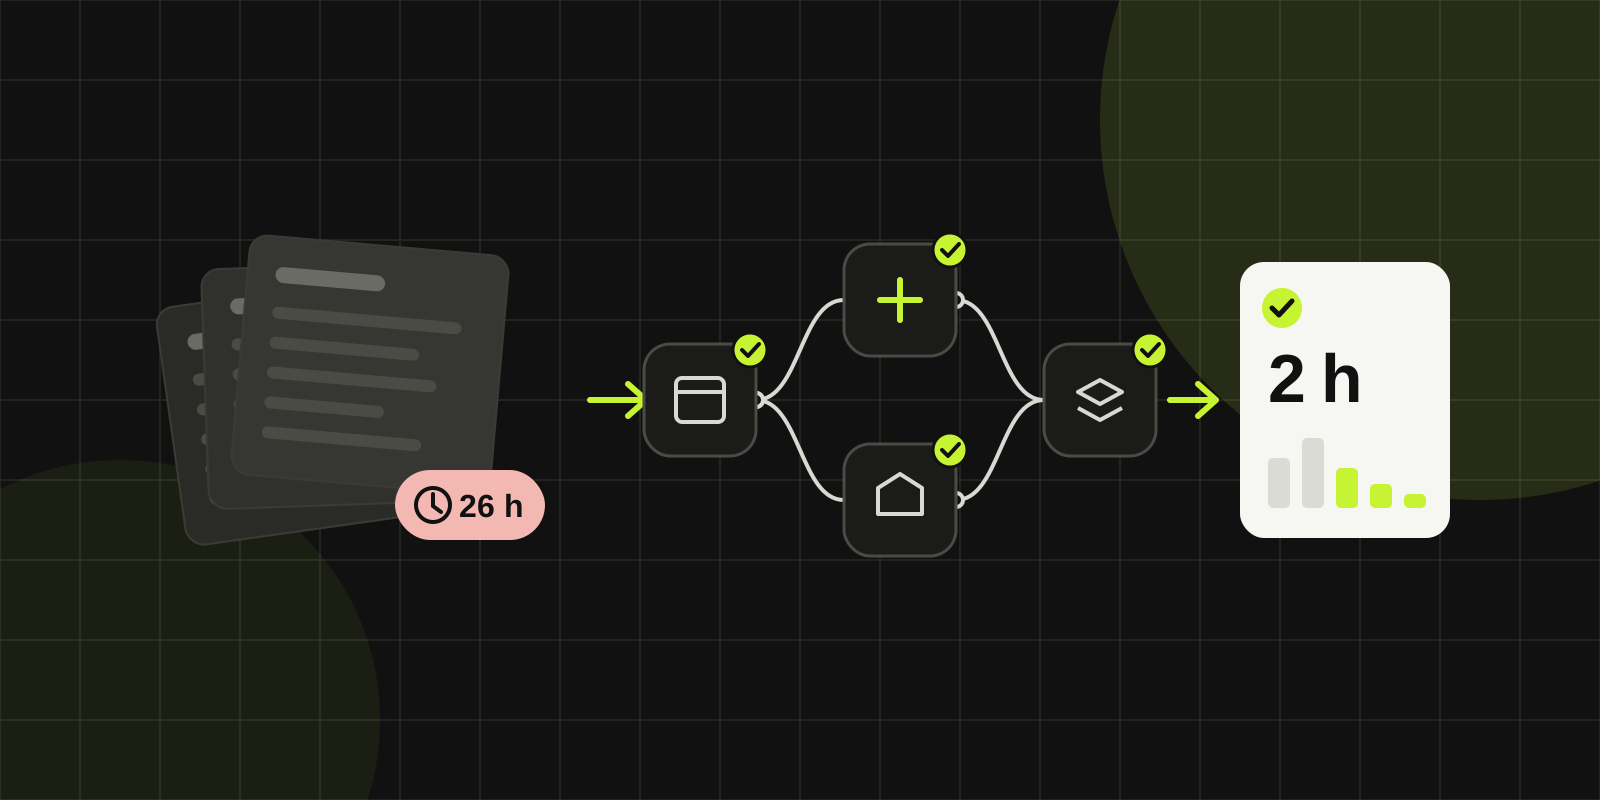
La pregunta que nos llega no es “¿qué es automatizar?”. Es “¿qué automatizo yo, en mi empresa, el mes que viene”. Y ahí es donde la mayoría de artículos se quedan en generalidades del tipo “empieza por un proceso repetitivo”, que no le sirven a nadie que tenga que decidir el lunes.
Así que vamos a lo concreto: qué es y qué no es automatizar, cómo elegir el primer proceso, ocho procesos donde vemos retorno de verdad (unos con IA y otros sin ella), cómo calcular si te compensa antes de gastarte un euro y con qué montarlo. Y sobre todo: qué NO automatizar, que suele ser la parte que se salta todo el mundo.
Qué es la automatización de procesos
La automatización de procesos consiste en que un sistema haga solo las tareas repetitivas de un proceso de tu empresa: pasar datos de un programa a otro, enviar avisos, generar documentos o tomar decisiones sencillas. Hay dos formas de hacerlo, y la diferencia importa porque cambia el coste y el riesgo.
Por reglas. “Si entra un pedido pagado, crea la factura y avisa al almacén”. Es la automatización de siempre: barata, predecible y perfecta mientras la realidad se comporte. La mayoría de los procesos que más horas devuelven son de este tipo y no necesitan IA.
Con IA. El problema es que la realidad a menudo llega en forma de correos escritos de mil maneras, facturas con veinte formatos distintos y clientes que explican su problema como pueden. Ahí es donde entra la IA: maneja la ambigüedad. Lee ese correo escrito de cualquier forma y saca los datos que importan. No es un oráculo, se equivoca, y a veces con mucha seguridad. Pero en tareas de leer, clasificar, extraer y resumir hace en segundos lo que a una persona le lleva minutos.
La consecuencia práctica es que los casos con IA que compensan tienen casi siempre la misma forma: mucho volumen, entrada desordenada, salida estructurada, y tolerancia a que un porcentaje pequeño necesite revisión humana. Si un proceso no cumple esas cuatro, o usas reglas o no es tu candidato.
Por dónde empezar: cómo elegir el primer proceso
El error más caro es empezar por lo más vistoso en lugar de por lo que más horas se come. Este es el orden que seguimos con cada cliente:
- Haz la lista de tareas repetitivas de una semana normal: quién las hace, cuántas veces y cuánto tarda cada una. Sin esa cifra no vas a poder demostrar nada después.
- Puntúa cada una con cuatro preguntas: ¿hay volumen?, ¿las reglas se pueden escribir?, ¿qué pasa si falla?, ¿los programas implicados tienen API o exportación?
- Elige una sola, pequeña y medible, con mucho volumen y poco riesgo si se equivoca. El primer proceso sirve tanto para ahorrar como para que tu equipo confíe en la automatización.
- Valídala barata. Móntala en una herramienta como n8n o Make y déjala correr con volumen real tres o cuatro semanas.
- Mide y amplía. Si el ahorro existe, pasa al siguiente de la lista; si no, has perdido poco.
Y antes de todo eso, una comprobación: si el proceso tiene pasos que no aportan nada, quítalos primero. Automatizar un proceso mal diseñado solo te da el mismo desorden más rápido.
8 procesos que suelen compensar primero
El primero no necesita IA: son reglas. Del segundo al séptimo sí, porque la entrada llega desordenada. El octavo combina ambas.
1. Sincronización entre sistemas
Un pedido entra en la tienda online y alguien lo copia en el programa de facturación, crea la factura y avisa al almacén. Multiplicado por cien pedidos al día.
Aquí no hace falta IA: son reglas que se pueden escribir. Un flujo recoge el pedido, crea la factura (en Holded, en el ERP o donde la hagas), avisa al almacén y deja constancia en el CRM. Es el caso más habitual y el que antes se amortiza, porque elimina el trabajo y además los errores de tecleo.
Dónde se rompe: cuando una de las APIs cambia o se cae y el flujo no tiene reintentos ni avisos. Un pedido que no llega a facturarse y nadie se entera es peor que hacerlo a mano.
2. Extracción de facturas y albaranes
El clásico y el que antes se amortiza. Llegan en PDF, en foto de móvil, escaneadas torcidas y con veinte maquetaciones distintas según el proveedor. Alguien las teclea.
El modelo lee el documento y devuelve campos estructurados: proveedor, CIF, número, fecha, base, IVA, total y líneas. Lo importante no es la extracción —eso funciona bien— sino el umbral de confianza: por debajo de cierto nivel, el documento va a una cola de revisión humana en lugar de entrar al sistema. Y la validación cruzada contra el ERP: si el CIF no existe como proveedor, o el total no cuadra con la suma de líneas, se para.
Dónde se rompe: facturas manuscritas, documentos multi-página donde las líneas siguen en la hoja tres, y proveedores que cambian de plantilla sin avisar.
3. Triaje y enrutado de tickets de soporte
Entran decenas de incidencias al día por correo y formulario, y alguien las lee todas para decidir de quién son.
El modelo clasifica por categoría y urgencia, detecta al cliente, y enruta. Bien montado, además redacta un borrador de primera respuesta que una persona revisa y envía —no que se envía solo—. Esa distinción es la diferencia entre ahorrar tiempo y generar una crisis de atención al cliente.
Dónde se rompe: el cliente enfadado que escribe tres párrafos de contexto y esconde la petición real en la última línea.
4. Cualificación y enriquecimiento de leads
Entran contactos por web, campañas y portales. No todos valen lo mismo, y el comercial los trata por orden de llegada.
El modelo lee el mensaje, lo cruza con lo que ya sabes de esa empresa y puntúa la intención. Los calientes se enrutan al instante con una tarea; el resto entra en nutrición.
Dónde se rompe: cuando nadie ha escrito qué es un lead bueno. Si el criterio vive en la cabeza del director comercial y no en un documento, el modelo aprende otra cosa. Este caso falla por razones de negocio, no técnicas.
5. Resumen de llamadas y actualización del CRM
El comercial cuelga y no apunta nada, o apunta “llamada ok”. Tres semanas después nadie sabe qué se habló.
Con la grabación de la centralita, el modelo transcribe, resume en cuatro líneas y rellena campos del CRM: siguiente paso, objeción principal, fecha de seguimiento. Se apoya en la integración telefónica que ya tengas montada —lo tratamos en integrar la centralita con Zoho CRM—.
Dónde se rompe: el RGPD. Grabar y procesar llamadas exige base legal, aviso e información al interlocutor. No es un detalle a resolver después.
6. Conciliación de cobros y remesas
Entra un cobro con el concepto “TRANSF FRA 23 Y 24 GARCIA” y alguien tiene que averiguar a qué facturas corresponde.
El modelo interpreta el concepto sucio, propone el casamiento contra las facturas abiertas de ese cliente y deja para revisión lo que no cuadra. Aquí el ahorro es alto porque hoy lo hace una persona de administración, a mano, todos los días.
Dónde se rompe: pagos parciales y agrupados. Necesita reglas claras de qué hacer cuando el importe no cuadra exactamente.
7. Buzón compartido de pedidos e incidencias
pedidos@empresa.com con quinientos correos al mes que alguien abre uno por uno.
El modelo clasifica, extrae los datos del pedido y crea el registro. Es el mismo patrón que usamos para los portales inmobiliarios, con el mismo talón de Aquiles: si el remitente cambia el formato, la extracción falla. Por eso el correo que no encaja nunca se descarta: se guarda en crudo y salta un aviso.
8. Calidad de datos del CRM
Duplicados, fichas sin sector, teléfonos mal formateados, empresas escritas de cuatro formas.
El modelo detecta duplicados que la coincidencia exacta no ve —“Construcciones García S.L.” y “CONSTRUCCIONES GARCIA SL”—, normaliza y propone fusiones para que alguien las apruebe. Es el paso previo a casi todo lo demás: automatizar sobre datos sucios solo propaga el desorden más rápido.
Cómo calcular si compensa, con números
Antes de contratar nada, haz esta cuenta. Con las facturas del caso 2:
- Hoy: 400 facturas al mes, 4 minutos cada una a mano = 26,6 horas/mes.
- Automatizado: el 85% entra solo. El 15% restante (60 facturas) necesita 1 minuto de revisión = 1 hora, más una hora de supervisión general = 2 horas/mes.
- Ahorro bruto: unas 24 horas al mes.
- Coste recurrente: el procesamiento por documento con un modelo comercial se mide en céntimos, así que a este volumen es marginal frente al coste de la persona.
Lo que decide el proyecto no es ese ahorro, es el coste de desarrollo dividido entre el ahorro mensual. Si montar el flujo cuesta el equivalente a seis meses de ahorro, es una buena inversión. Si cuesta tres años, ese proceso no era el candidato.
Y hazte la cuenta con el volumen real, no con el que te gustaría tener. Automatizar 30 facturas al mes no compensa casi nunca: el mismo trabajo de ingeniería repartido entre menos documentos.
Con qué se construye: n8n, Make o código propio
Hasta aquí hemos hablado de qué automatizar. Falta la pregunta que decide el presupuesto: con qué lo montas. Y aquí hay una respuesta que casi nadie da, porque quien vende la herramienta no tiene incentivo para darla.
Las plataformas de automatización visual —n8n, Make, Zapier— son excelentes para descubrir si un proceso merece automatizarse. Montas el flujo en dos tardes, lo pones a correr con volumen real y a las tres semanas sabes si el ahorro que calculaste sobre el papel existe de verdad. Eso, como validación, no tiene precio: es la forma más barata de equivocarte.
El problema aparece justo después, cuando el proceso ya demostró que sí compensa y empieza a crecer.
Dónde deja de salir a cuenta
El precio crece con el volumen. Make cobra créditos por cada acción de cada módulo y Zapier cobra una tarea por cada paso: un proceso de diez pasos que corre mil veces al mes consume unas diez mil. n8n Cloud cuenta distinto, por ejecución completa del flujo y sin importar cuántos pasos tenga, pero cada plan tiene su tope de ejecuciones al mes. En los tres casos, la factura crece igual de rápido que el éxito del proyecto. Es el único software que te penaliza por funcionar bien.
Depurar es a ciegas. Cuando un flujo de treinta nodos falla en el veintidós, a las tres de la mañana, tienes el log de ejecución y poco más. No hay traza, no hay test que reproduzca el caso, no hay forma de saber si el fallo es del dato, de la API de terceros o de una condición que nadie contempló.
No hay control de versiones de verdad. El flujo vive en la herramienta, no en tu repositorio. No hay rama, ni revisión, ni diff que enseñe qué cambió entre lo que funcionaba y lo que dejó de funcionar. Si dos personas tocan el mismo flujo, gana quien guarde el último.
La lógica condicional tiene un techo visual. Pasadas cinco o seis ramas, el lienzo deja de ser un diagrama y pasa a ser un plato de espaguetis. Lo mismo que lo hacía rápido de construir lo vuelve lento de entender, y a los seis meses nadie se atreve a tocarlo.
Cómo lo planteamos nosotros
No es una elección ideológica, es una secuencia. Empezamos en la plataforma visual porque valida barato, y migramos a código cuando aparece alguna de estas tres señales: lo que pagas a la plataforma se acerca a lo que costaría mantener un servicio propio, el proceso se ha vuelto crítico y ya no tolera fallar en silencio, o la lógica ha crecido hasta el punto de que nadie del equipo la entiende del todo.
Migrar en ese momento no es rehacer el trabajo: el flujo visual ya te dijo exactamente qué tiene que hacer el código. Ese es su verdadero valor, y por eso empezar por ahí casi nunca es tiempo perdido.
Hay un matiz que conviene conocer: n8n se puede autoalojar, y eso elimina de un plumazo el coste por ejecución. En nuestro servicio de agencia n8n lo montamos así cuando el volumen o los datos lo justifican. A cambio, asumes el mantenimiento de la infraestructura. Para un volumen alto y un equipo con capacidad técnica, suele ser la opción más sensata de las tres.
Si estás en ese punto —la automatización funciona pero la factura o la fragilidad empiezan a molestar—, eso es automatización de procesos y es exactamente el trabajo que hacemos.
Dónde la IA no es la respuesta
Ser honesto aquí es lo que separa un proyecto rentable de un juguete caro.
No la uses cuando el proceso exige el cien por cien de acierto sin supervisión: nóminas, presentaciones fiscales, cálculos que van a Hacienda. No la uses cuando el volumen es bajo, porque el esfuerzo de ingeniería no se amortiza. Y no la uses cuando la decisión tiene consecuencias legales, sanitarias o de seguridad que nadie debería delegar en un modelo.
Y recuerda lo que decíamos al principio: automatizar un proceso que está mal diseñado casi nunca compensa. Si tu circuito de aprobación tiene cinco pasos redundantes, automatizarlo te da los cinco pasos redundantes más rápido.
Errores que conviene evitar
- Empezar por el chatbot. Es lo más vistoso y casi siempre lo de menor retorno. Los casos aburridos —facturas, conciliación, triaje— son los que devuelven horas. Cuándo sí compensa uno, y cuál de los tres tipos, lo desglosamos en chatbot para empresas.
- Automatizar sobre datos sucios. Si el CRM tiene duplicados, la IA los propaga a más velocidad y hacia más sistemas.
- No definir el umbral de confianza. Sin un punto a partir del cual el caso pasa a revisión humana, el modelo mete errores silenciosos en tu contabilidad.
- No medir el antes. Si no sabes cuántas horas se van hoy, no vas a poder demostrar el retorno después y el proyecto se juzgará por sensaciones.
- Dejar que el modelo escriba al cliente sin revisión. El ahorro de esa última milla es pequeño y el riesgo reputacional es enorme.
- Mandar datos personales a un servicio externo sin decidirlo. Es una decisión de arquitectura y de RGPD, no un detalle de implementación.
- Pilotar sin plan de salida. Si la prueba sale bien, ¿quién lo mantiene? Un piloto que nadie puede operar en producción es dinero gastado.
Persona en el bucle y privacidad, siempre
Dos principios que no negociamos.
Una persona en el bucle. Para cualquier proceso con impacto, la IA propone y una persona valida, especialmente en los casos límite. Con el tiempo, según los datos demuestran fiabilidad, se amplía el margen de automatización. Se empieza con supervisión y se relaja, nunca al revés.
Privacidad desde el diseño. Automatizar implica mover información de tu negocio, a menudo datos personales sujetos al RGPD. Qué datos salen, hacia dónde y con qué garantías se decide al principio. No todo tiene que pasar por un servicio externo, y elegir bien la arquitectura es parte del trabajo. Lo desarrollamos en RGPD e IA: qué pasa con tus datos en un LLM.
Cierre
En LMNHUB abordamos la automatización de procesos, con o sin IA aplicada, como ingeniería aplicada a tus procesos: medible, integrada con los sistemas que ya usas y con una persona supervisando donde toca. Empezamos por un caso concreto, medimos el retorno real y ampliamos solo lo que lo demuestra.
Si tienes un proceso que te está comiendo horas, cuéntanos tu caso y te decimos con franqueza por dónde empezar, si la IA es la respuesta o si el problema es otro.